Capa: ilustração conceitual criada com IA, segundo a identidade Arkmeds. Não representa um ensaio ou uma medição real.
IA pode apoiar a engenharia clínica na organização de registros, na redação e na priorização do trabalho. Para avaliar esse apoio, defina qual tarefa será executada, como conferir o resultado e quem responde pela decisão. Uma resposta fluente ou um percentual alto de acerto não demonstram, sozinhos, que a ferramenta é adequada à sua operação.
Medição, integração e IA são a mesma coisa?
Imagine uma ordem de serviço que reúne valores do analisador, dados do cadastro e uma conclusão sugerida. Essas informações têm origens diferentes. Reconhecer a origem permite investigar o erro certo, em vez de tratar qualquer preenchimento como uma medição.
| Origem | O que produz | O que conferir |
|---|---|---|
| Instrumento de ensaio | Resultado de uma medição ou simulação definida | Ativo, instrumento, procedimento, configuração e unidade |
| Integração de software | Transferência ou associação de dados | Campo, cadastro e serviço de destino |
| Modelo de classificação | Categoria ou prioridade segundo um modelo | Referência usada, erros por categoria e pertinência ao contexto |
| IA generativa | Texto ou síntese sugerida | Fidelidade ao registro, fontes e informações acrescentadas |
A revisão muda conforme a tarefa. Transferir uma leitura e sugerir uma conclusão são etapas diferentes. O procedimento técnico aplicável ao equipamento continua orientando o ensaio; a avaliação de software não substitui a avaliação física.
Uma IA pode inventar a referência de uma norma ou estudo?
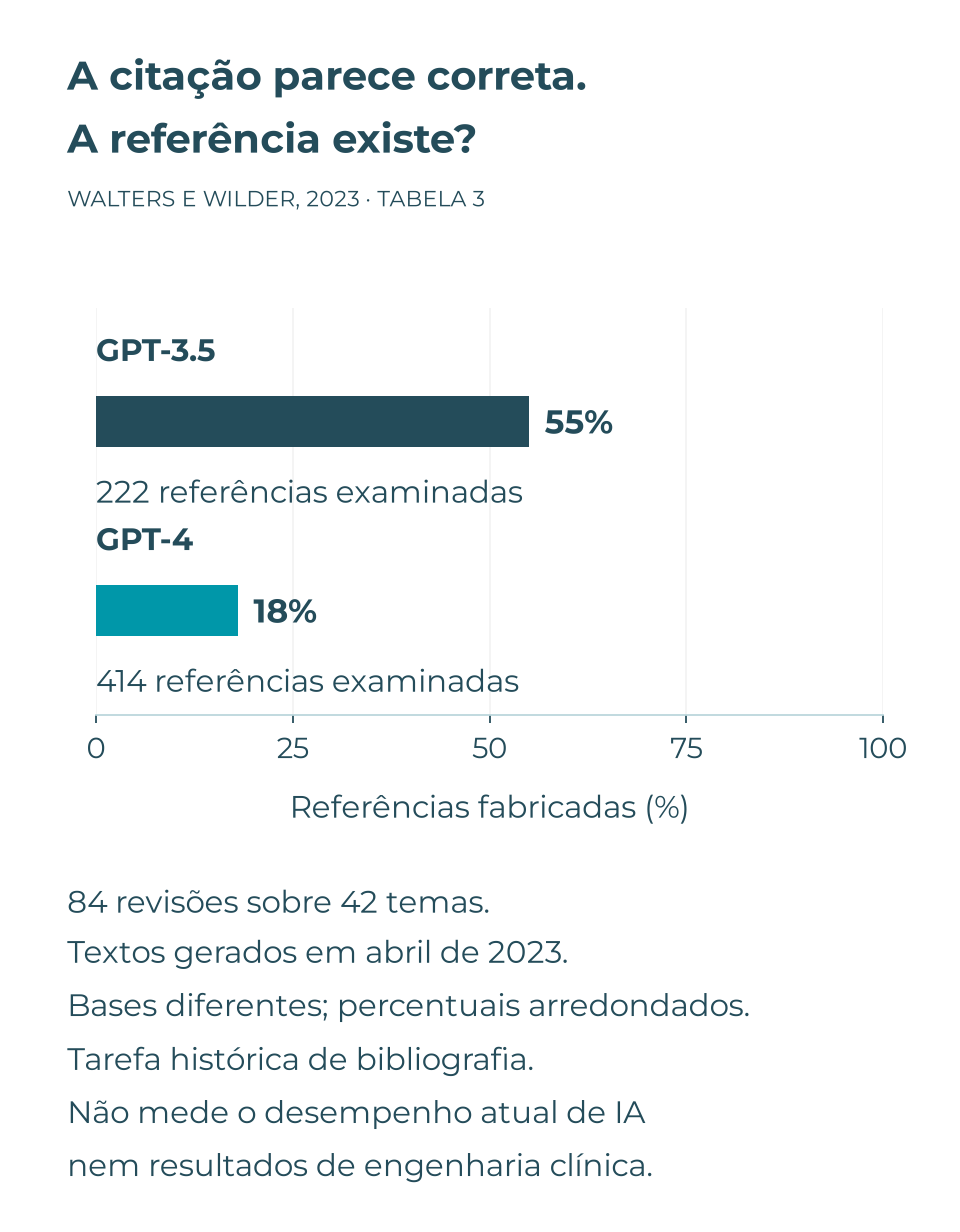
Uma citação bem formatada pode corresponder a uma obra inexistente. Walters e Wilder (2023) conferiram 636 referências de 84 revisões geradas sobre 42 temas na primeira semana de abril de 2023. A Tabela 3 registrou 55% de referências fabricadas no GPT-3.5 e 18% no GPT-4, com denominadores diferentes.
| Modelo avaliado em abril de 2023 | Referências examinadas | Percentual fabricado publicado |
|---|---|---|
| GPT-3.5 | 222 | 55% |
| GPT-4 | 414 | 18% |
Esses dados descrevem uma tarefa histórica de bibliografia, não erros atuais de IA em engenharia clínica ou desempenho Arkmeds. Para a documentação técnica, a consequência é prática: abra a fonte original antes de incorporar norma, procedimento ou tolerância. Confirme existência, edição e relação com o serviço. Uma publicação verdadeira também pode ser citada com dados incorretos.
O NIST AI 600-1, de 2024, trata da geração confiante de conteúdo falso e recomenda conferir fontes e citações, além de avaliar capacidades empiricamente. Pedir à mesma ferramenta que confirme sua resposta não equivale a uma verificação independente.
Como 95% de acerto podem esconder todos os casos de alta prioridade?
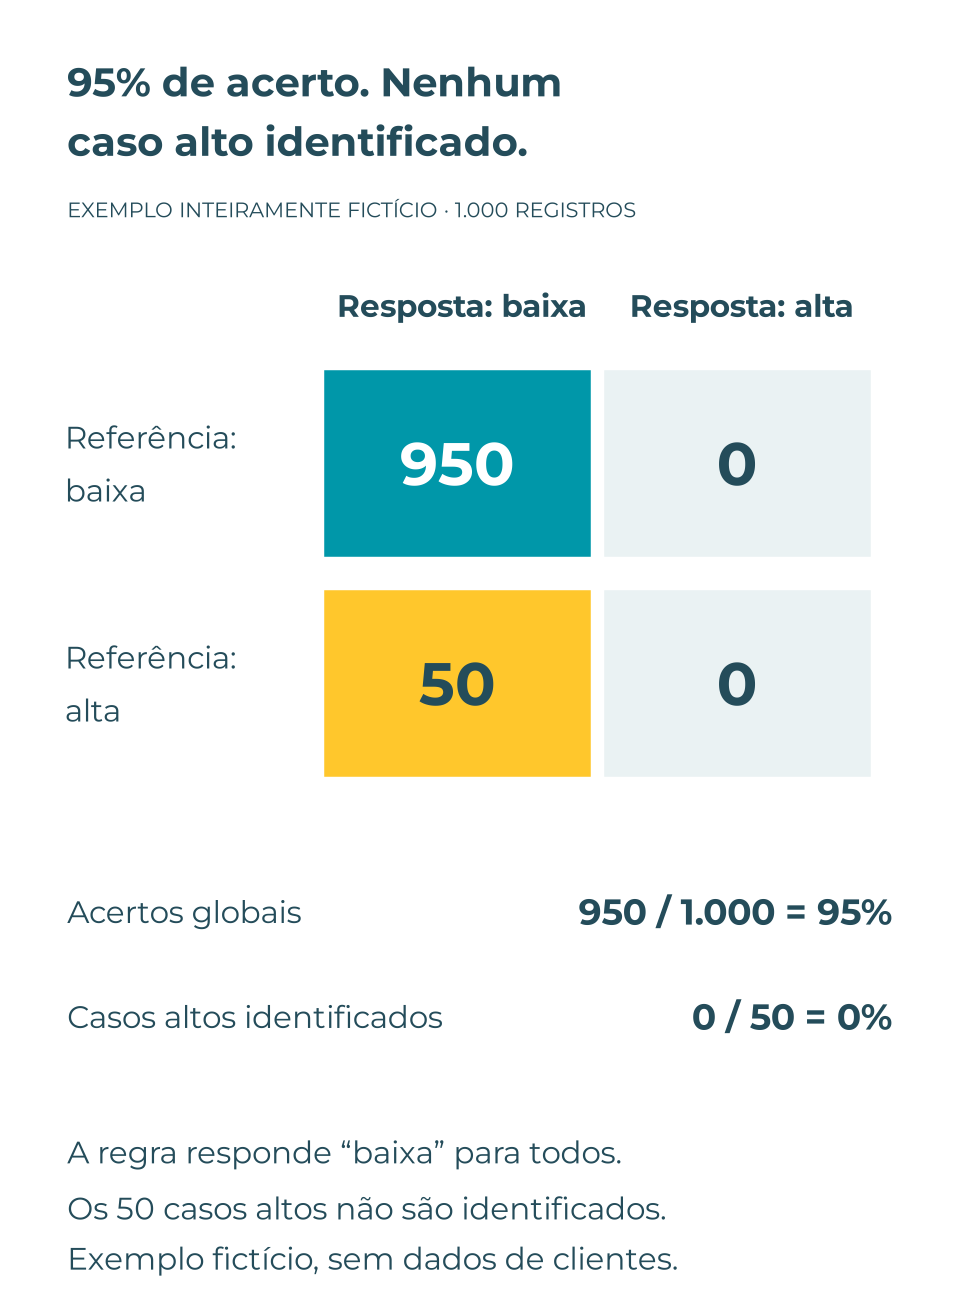
Considere um exemplo inteiramente fictício, sem equipamentos ou clientes reais. Uma base contém 1.000 registros: 950 classificados previamente como baixa prioridade e 50 como alta. Uma regra simplista responde “baixa prioridade” para todos.
| Categoria de referência fictícia | Resposta: baixa | Resposta: alta | Total |
|---|---|---|---|
| Baixa prioridade | 950 | 0 | 950 |
| Alta prioridade | 50 | 0 | 50 |
| Total | 1.000 | 0 | 1.000 |
A regra acerta 950 de 1.000 registros: acurácia global de 95%. Porém, identifica zero dos 50 registros de alta prioridade: recall dessa categoria de 0%. Como não prevê nenhum caso alto, sua precisão para essa categoria não é calculável com esse denominador; não se deve inventar um valor.
O exemplo mostra por que vale pedir a matriz de confusão e resultados por categoria. A frequência dos casos influencia a métrica global. Não é um limiar de aceitação para manutenção: a instituição precisa definir critérios coerentes com a tarefa e as consequências dos erros.
O que uma pesquisa hospitalar de 2026 permite concluir?
Ye e colaboradores analisaram 9.924 dispositivos de um hospital de Wenzhou, na China: 8.967 no conjunto de manutenção preventiva e 957 no de corretiva. Os modelos classificaram urgência com rótulos derivados de agrupamentos estatísticos. As acurácias de teste publicadas foram 93,79% e 86,46%, respectivamente.
Acertar esses rótulos não demonstra acerto contra uma referência clínica externa. Os próprios autores explicam essa limitação. A comparação posterior envolveu 830 dispositivos no campus de intervenção e 849 no controle, em 2025, e foi quase experimental. Possíveis confundidores impedem tratar as associações como prova causal ou promessa de economia. O estudo não avaliou Arkmeds nem um LLM redigindo laudos.
A pergunta útil ao fornecedor é: “Seu percentual compara a saída com qual referência, em quais equipamentos e em qual período?”. Um resultado pode ser válido para reproduzir uma categoria de treinamento e ainda não responder à pergunta operacional que sua equipe precisa resolver.
Como testar uma sugestão de laudo com os registros da equipe?
Escolha uma tarefa delimitada, como apontar lacunas ou produzir uma síntese de serviços já documentados. Preserve a informação original e inclua casos com pendências, campos ausentes e unidades que não podem ser trocadas. Use dados autorizados para esse ambiente e registre o modelo e a configuração avaliados.
Neste caso fictício OS-FIC-042, o registro diz “bateria substituída; teste de desempenho pendente”. Uma sugestão escreve “equipamento aprovado e liberado”. A frase acrescenta uma conclusão que não está sustentada. A revisão deve manter a pendência e devolver a conclusão ao responsável técnico, sem completar a evidência por suposição.
| Campo do registro de avaliação | Exemplo adaptável |
|---|---|
| Tarefa e entrada | Sintetizar OS-FIC-042; versão do registro original |
| Saída e divergência | Sugestão acrescentou aprovação sem ensaio documentado |
| Tratamento | Rejeitar a conclusão; conservar a pendência |
| Responsável | Pessoa que revisou e evidência consultada |
| Continuidade | Corrigir entrada ou configuração e repetir os casos afetados |
Meça omissões de pendências, fatos acrescentados sem evidência, troca de unidade ou ativo, sugestões rejeitadas e tempo de revisão. Inclua a revisão no tempo total, não apenas a geração. Mantenha denominadores: sugestões com ao menos uma divergência / sugestões examinadas é diferente de total de divergências, pois uma sugestão pode conter várias.
Como o CMMS ajuda a conferir os registros?
Uma base organizada facilita recuperar o que foi executado e conferir o que o software sugere. A plataforma CMMS Arkmeds reúne ordens de serviço e histórico dos ativos. A aplicação móvel permite trabalhar em campo sem internet e sincronizar os registros quando a conexão retorna, conforme os recursos e a configuração utilizados.
O benefício relevante é consultar a evidência junto do serviço, preservando a diferença entre resultado medido, dado transferido e sugestão. Avalie disponibilidade após sincronização, associação ao ativo correto e possibilidade de acompanhar a correção. Recursos de organização documental não recebem os resultados dos estudos citados e não demonstram, por si, validade de um modelo de IA.
Quais referências ajudam a organizar um piloto?
O NIST AI RMF 1.0, de 2023, orienta avaliar em condições semelhantes às de uso, documentar as medidas e acompanhar o comportamento em operação. É um referencial voluntário e multissetorial; não certifica um software de engenharia clínica. Em 6/10/2026, o NIST informa que a versão 1.0 está em revisão.
A OMS, no guia de inventário e manutenção de 2025, aborda consistência de entrada, validação da migração e treinamento na implantação de CMMS (§7.5). Esses aspectos ajudam a preparar a base. O plano de avaliação e o caso apresentados aqui são propostas editoriais adaptáveis, não formulários oficiais da OMS ou do NIST.
O que fazer quando o modelo ou o fluxo mudar?
Registre a mudança de versão, configuração ou fonte de dados e reavalie os casos afetados. Compare períodos equivalentes, incluindo complexidade dos serviços e tempo de revisão. Preserve o caminho para rejeitar sugestões e corrigir registros. Uma melhora em exemplos conhecidos merece investigação; o uso cotidiano precisa manter evidência de utilidade e acompanhamento dos erros.
Onde aprofundar o tema de dados na engenharia clínica?
O vídeo em português do canal Arkmeds, O papel da Engenharia Clínica na Era dos dados e da Inteligência Artificial, é um material complementar para a discussão. Os dados e conclusões deste artigo estão vinculados às fontes primárias abaixo; não foram extraídos da palestra.
Fontes e leituras
- Walters & Wilder (2023) — Fabrication and errors in the bibliographic citations generated by ChatGPT
- Ye et al. (2026) — A data-driven priority assessment and deployment framework for medical equipment maintenance in a tertiary hospital
- NIST AI 600-1 (July 2024) — Generative Artificial Intelligence Profile
- NIST AI RMF 1.0 (January 2023) — Artificial Intelligence Risk Management Framework
- NIST — AI Risk Management Framework, current status
- WHO (2025) — Inventory and maintenance management information system for medical devices
- Arkmeds — CMMS maintenance management platform
- Arkmeds — Palestra | O papel da Engenharia Clínica na Era dos dados e da Inteligência Artificial (Portuguese)
Pesquisa e revisão de fontes: 6 de outubro de 2026. Gráficos próprios; matriz e OS-FIC-042 inteiramente fictícias.
Data original do arquivo: 2026-10-04. Data editorial reorganizada em 8 de outubro de 2026.