Capa: ilustração conceitual gerada por IA, segundo a identidade Arkmeds. Não representa um ensaio ou medição real.
Um painel mostra MTTR de quatro horas, MTBF de 200 horas e 20 ordens de serviço pendentes. Esses números permitem decidir o que melhorar? Só depois de saber quais eventos foram contados, qual relógio foi usado e o que ainda ficou fora do cálculo.
A resposta em resumo: MTBF relaciona tempo de operação e falhas; MTTR resume uma duração de reparo ou restauração que precisa ser definida; backlog descreve trabalho pendente em uma data de corte. Leia os três junto com utilização, criticidade, distribuição dos tempos e qualidade das OS. Um indicador isolado não identifica a causa do problema.
Qual a diferença entre MTTR, MTBF e backlog?
Cada medida responde a uma pergunta. O erro começa quando a equipe usa o mesmo nome para relógios diferentes ou compara períodos com regras de contagem diferentes.
| Indicador | Pergunta que ajuda a responder | Informação que precisa acompanhá-lo |
|---|---|---|
| MTBF estimado | Quantas horas de operação foram observadas por falha? | Horas efetivamente observadas, número e definição de falhas, ativos e período |
| MTTR definido no painel | Quanto duraram os episódios de reparo concluídos? | Início e fim escolhidos, quantidade de episódios, mediana e pendências excluídas |
| Backlog na data de corte | Quanto trabalho ainda precisa ser feito? | OS válidas, esforço estimado, prioridade, idade e motivo de bloqueio |
| Preventivas realizadas no prazo | Que parte do plano venceu com execução dentro do prazo? | OS previstas com vencimento no período e regra para reprogramações |
A OMS inclui confiabilidade, tempos de manutenção, utilização, peças e cumprimento das preventivas entre as dimensões do acompanhamento de equipamentos. Não são medidas intercambiáveis. [1]
Para padronizar a linguagem, a EN 13306:2017 é uma referência de terminologia, adotada no Reino Unido como BS EN 13306:2017. A BSI confirma essa edição em seu catálogo. Os exemplos abaixo usam definições operacionais editoriais; não reproduzem o texto integral da norma nem estabelecem metas normativas para hospitais. [2]
Como calcular MTBF sem confundir operação com calendário?
Sob um modelo de ocorrência de falhas com taxa constante, uma estimativa de MTBF usa tempo total observado de operação ÷ número de falhas. O NIST apresenta esse estimador e as hipóteses do modelo. Uma média descritiva não demonstra, por si só, que a taxa permaneceu constante. [3] [4]
Exemplo fictício: um ativo reparável acumulou 1.200 horas de operação e seis falhas no período analisado. A estimativa é 200 horas por falha. Ela não significa que a próxima falha acontecerá exatamente daqui a 200 horas.
O tempo sem utilização não deve entrar silenciosamente como operação. Se a base contém apenas datas de abertura de OS, o intervalo entre duas datas pode incluir espera, indisponibilidade e períodos sem uso. Identifique esse resultado como intervalo de calendário e explique sua base; não o apresente como horas de funcionamento medidas.
Ao reunir vários ativos, some a exposição elegível e as falhas correspondentes antes de calcular a razão. Compare equipamentos com função, uso e ambiente semelhantes. Investigue mudanças de carga e de registro antes de concluir que houve melhora de confiabilidade.
E se não houve falha? Informe, por exemplo, “zero falhas em 500 horas de operação observadas”, com a quantidade de ativos e o período. Dividir por zero não fornece uma estimativa finita de MTBF; a ausência de falhas nessa janela também não demonstra vida infinita. Para inferência ou compromisso contratual, é necessário um método estatístico adequado, com suas hipóteses e incerteza. [3]
MTTR mede reparo ou todo o tempo sem equipamento?
Escreva os marcos no dicionário do painel. Neste artigo, o exemplo de tempo de reparo vai do início ao fim do reparo; a indisponibilidade observada vai da perda de disponibilidade até a liberação para uso. Não equivale automaticamente às horas trabalhadas pela equipe.
| Marco de um caso fictício | Horário | O que o intervalo informa |
|---|---|---|
| Falha registrada e equipamento indisponível | 08h00 | Início da indisponibilidade neste exemplo |
| Reparo iniciado | 10h00 | Duas horas até iniciar o reparo |
| Reparo concluído | 12h00 | Duas horas de duração do reparo |
| Verificações e liberação concluídas | 13h30 | Mais uma hora e meia até voltar ao uso |
Nesse caso, o reparo durou duas horas, enquanto a indisponibilidade foi de cinco horas e meia. Se o painel mistura os dois relógios, a discussão sobre desempenho começa com uma ambiguidade.
Registre também esperas por peça, fornecedor, acesso ao equipamento e verificação. Intervalos sobrepostos não devem ser somados duas vezes. Para planejar pessoas, acompanhe horas de trabalho separadamente: duas pessoas atuando por uma hora representam duas horas-pessoa, mas apenas uma hora decorrida.
Como medir disponibilidade sem misturar relógios?
Defina quando o equipamento precisava estar disponível, inclusive o tratamento de reserva e standby. Disponibilidade para uso não é o mesmo que utilização efetiva.
No exemplo fictício anterior, suponha uma janela de 24 horas em que o ativo deveria estar disponível. Com 5,5 horas de indisponibilidade, sobram 18,5 horas disponíveis. A razão observada é 18,5 ÷ 24 × 100 = 77,1%, arredondada. É um resultado daquela janela, sem previsão do mês seguinte.
Não substitua essa observação por uma combinação de MTBF em horas de funcionamento e MTTR que exclui parte da indisponibilidade. Preserve a janela, os marcos e a regra do cálculo. Assim, a equipe distingue tempo disponível, tempo usado e tempo gasto na restauração.
Por que a média de reparo precisa de mediana e pendências?
Exemplo inteiramente fictício: 12 reparos concluídos tiveram durações de 1 hora em 11 casos e de 37 horas em um caso. O total é 48 horas, a média é 4 horas e a mediana é 1 hora. A média sozinha não mostra onde se concentrou a demora.
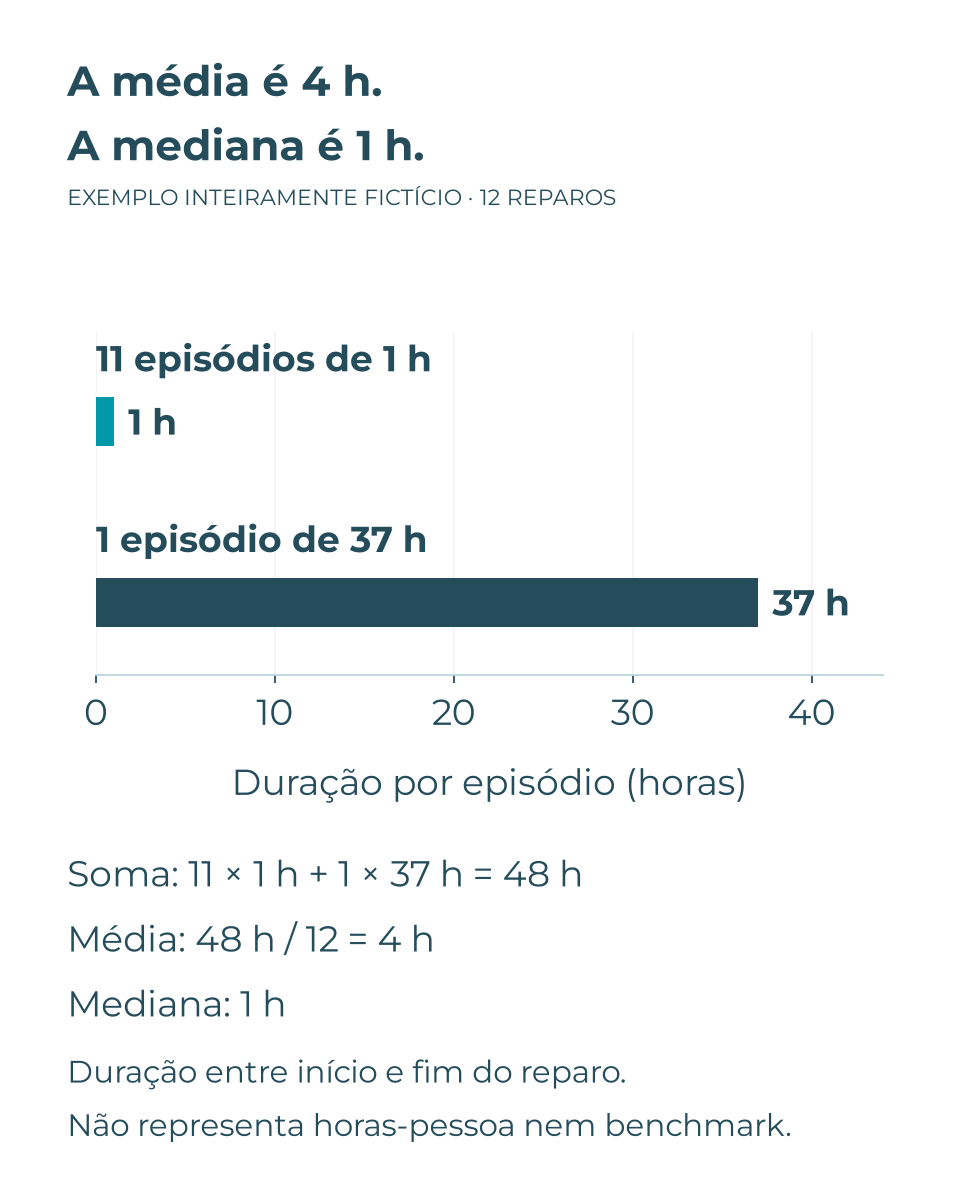
| Duração de cada episódio | Episódios concluídos | Soma das durações |
|---|---|---|
| 1 h | 11 | 11 h |
| 37 h | 1 | 37 h |
| Total | 12 | 48 h; média 4 h; mediana 1 h |
O caso longo precisa de investigação: diagnóstico, logística, execução, verificação ou registro? A distribuição aponta onde olhar, mas não responde qual foi a causa.
Também há um viés possível ao considerar apenas o que terminou. Se existe um 13º episódio ainda aberto há 60 horas, ele não entra na média dos 12 concluídos. Mostre a quantidade e a idade das pendências ao lado da média, para que uma fila de casos difíceis não desapareça do painel.
Um estudo brasileiro publicado por Silva e colegas em 2025 analisou registros de bombas de infusão exportados de um hospital, de 2008 a 2021. A tabela 2 mostra o seguinte contraste: [5]
| Setor no estudo | Média do tempo registrado | Mediana do tempo registrado |
|---|---|---|
| UTI neurológica | 38,82 h | 7,76 h |
| Centro cirúrgico cardiológico | 78,09 h | 1,67 h |
A tabela 1 apresenta 193 bombas distribuídas por setores, mas a tabela 2 não informa a quantidade de episódios de cada linha. Os autores relatam OS encerradas fora do prazo esperado, afetando as durações registradas. Esses valores não são metas de reparo nem comparação de produtividade entre equipes. A contribuição prática é conferir os marcos e a distribuição antes de interpretar a média. [5]
Backlog é o mesmo que preventiva atrasada?
Não necessariamente. Para este painel, backlog é o conjunto de trabalho pendente na data de corte. Ele pode conter corretivas, preventivas e outros serviços elegíveis. Separe o que está pronto para executar do que depende de peça, fornecedor, acesso ou autorização.
“24 de 80 preventivas previstas não foram executadas no prazo” corresponde a 30% de descumprimento daquele plano. Esse percentual não descreve todo o trabalho pendente e não informa quantas horas a equipe precisa para realizá-lo.
Outro exemplo fictício: duas filas têm 20 OS. Na fila A, cada OS exige uma hora-pessoa estimada; na B, quatro horas-pessoa. A contagem é igual, mas a carga estimada é de 20 e 80 horas-pessoa, respectivamente.
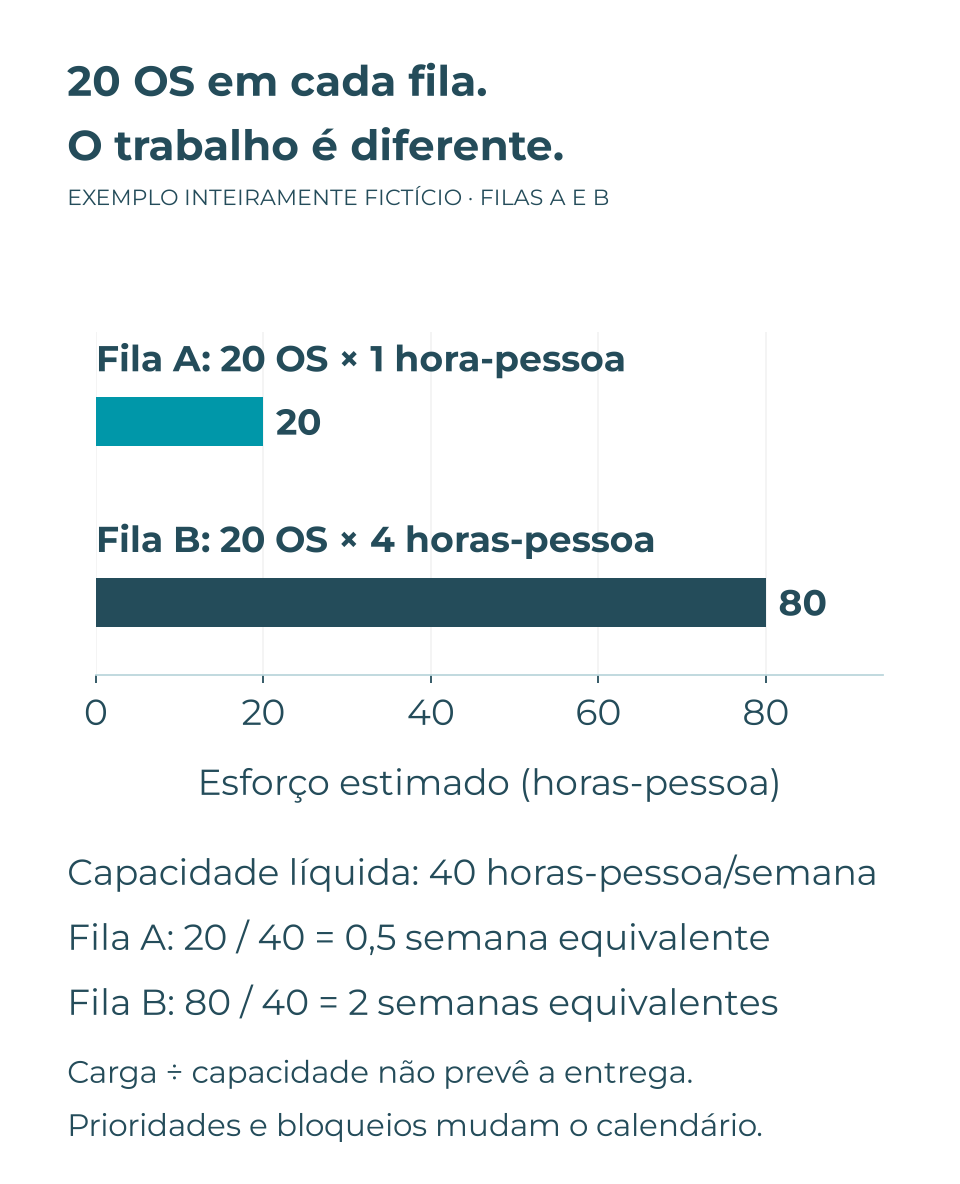
| Fotografia fictícia da fila | OS pendentes | Esforço estimado | Capacidade líquida usada no exemplo |
|---|---|---|---|
| Fila A | 20 | 20 horas-pessoa | 40 horas-pessoa por semana |
| Fila B | 20 | 80 horas-pessoa | 40 horas-pessoa por semana |
Carga dividida por capacidade resulta em 0,5 e 2 semanas equivalentes de trabalho. A capacidade líquida precisa reservar o tempo das outras atividades. Esse cálculo não promete uma data de conclusão: emergências, prioridades, sequenciamento e bloqueios podem alterar o calendário.
Não deixe a soma esconder uma pendência crítica. Exiba idade, prioridade e condição clínica de uso ao lado da carga. Uma OS pequena pode exigir atenção imediata; um volume grande de tarefas rotineiras não determina sozinho a prioridade.
Como transformar os indicadores em uma decisão de manutenção?
Use o painel como ponto de partida para investigar, registrando a hipótese e a evidência necessária para confirmá-la.
| Sinal observado | Próxima pergunta | Evidência a procurar |
|---|---|---|
| Média cresce; mediana muda pouco | Poucos episódios longos estão dominando o resultado? | Distribuição e marcos desses casos; motivo das esperas |
| Backlog em horas aumenta | Entrou mais trabalho ou caiu a capacidade disponível? | Entradas, conclusões, esforço estimado e capacidade líquida |
| Estimativa de MTBF aumenta | Houve mudança de exposição ou de registro de falhas? | Horas de operação, cobertura dos registros e condições de uso |
| OS reabrem após encerramento | É retorno da mesma falha ou um evento distinto? | Ativo, modo de falha, vínculo entre OS e janela de acompanhamento |
Se usar resolução no primeiro atendimento, defina o evento elegível e a janela de retorno. Um percentual de resolução não informa sozinho o número médio de atendimentos: registre os atendimentos efetivos, em vez de deduzi-los como o inverso da taxa. Casos encerrados recentemente também precisam completar a janela antes da comparação.
O CMMS ajuda quando essas regras chegam aos registros. A plataforma da Arkmeds oferece histórico por ativo, fluxo de OS, Kanban e painéis personalizáveis com MTTR, MTBF e SLA, conforme sua documentação. A aplicação útil é configurar marcos, pendências e responsabilidades para que a equipe consiga reconstruir cada número. Esses recursos não demonstram uma redução de falhas ou de tempos por si só. [6]
O que registrar antes de comparar dois meses?
Guarde um dicionário com evento, relógio, população, período e exclusões. Registre datas de falha, início de atendimento, início/fim de reparo, liberação e motivos de bloqueio; use um identificador estável do ativo e vincule os retornos à OS original quando aplicável.
No fechamento, mostre as contagens e a exposição junto das médias. Preserve uma fotografia das pendências e das regras vigentes. Se a forma de medir mudou, identifique a mudança na série histórica: o próximo mês só será comparável quando a base da comparação estiver clara.
Fontes e leituras
- OMS (2025). Inventory and maintenance management information systems for medical devices.
- BSI. BS EN 13306:2017 — Maintenance terminology; current edition catalogue.
- NIST/SEMATECH. e-Handbook §8.4.1.2 — Maximum likelihood estimation.
- NIST/SEMATECH. e-Handbook §8.1.7.1 — Homogeneous Poisson Process.
- Silva et al. (2025). Reliability analysis of hospital infusion pumps: a case study. BioMedical Engineering OnLine 24,55.
- Arkmeds. Plataforma de gestão da manutenção — funcionalidades oficiais.
Exemplos e gráficos fictícios elaborados para explicar as contas; não representam dados de clientes. Resultados publicados recebem referência própria. A Arkmeds fornece o CMMS mencionado. Pesquisa e revisão: 6 de outubro de 2026.