Capa: ilustração conceitual gerada por IA, segundo a identidade Arkmeds. Não representa um ensaio ou medição real.
Um painel informa MTBF de 2.160 horas para uma família de equipamentos. A divisão por 24 resulta em 90 dias, mas isso prevê uma falha a cada 90 dias? Essa conclusão confunde uma medida de confiabilidade com uma data marcada no calendário.
MTBF não prevê quando um equipamento específico vai falhar. Para interpretar o número, confira horas de operação, eventos contados, condições de uso e incerteza. O indicador ajuda a investigar a manutenção; sozinho, não define a periodicidade de ensaio nem comprova segurança para uso.
O que entra no cálculo do MTBF?
Para sistemas reparáveis sob um modelo de ocorrência de falhas com taxa constante, a estimativa usual é exposição operacional acumulada ÷ número de falhas. O NIST apresenta esse estimador e suas hipóteses. A exposição inclui o tempo observado dos ativos que não falharam; contar apenas os intervalos encerrados por uma falha perde informação. [1] [2]
Exemplo fictício: uma família elegível acumula 1.200 horas de funcionamento e seis eventos de falha. A estimativa é 200 horas por falha. Antes de comparar, documente o que é uma falha e se um retorno à assistência é um evento novo ou a continuação da ocorrência anterior.
| Informação do painel | O que registrar | Confusão que a definição evita |
|---|---|---|
| Exposição | Horas de operação efetivamente observadas | Usar calendário ou número de equipamentos como se fosse tempo de uso |
| Evento | Critério de falha e regra para retornos | Contar abertura, reabertura e atendimento como falhas diferentes |
| População | Função, modelo, ambiente e condições de uso | Misturar ativos com cargas ou funções muito diferentes |
| Período | Início, fim e cobertura dos registros | Comparar janelas com dados incompletos |
O intervalo da falha até a liberação do equipamento descreve restauração ou indisponibilidade, conforme os marcos escolhidos. Não é a exposição operacional entre falhas. Para comparar esses relógios com MTTR e backlog, veja o guia de interpretação dos indicadores.
Por que 2.160 horas não significam uma falha em 90 dias?
Primeiro, 2.160 horas de funcionamento só correspondem a 90 dias de calendário se houver 24 horas de operação por dia nesse intervalo. Um equipamento utilizado oito horas por dia levaria 270 dias de uso nesse ritmo para acumular a mesma exposição. Converter a unidade não transforma a média em previsão. Esses dois cálculos são ilustrativos, não uma recomendação de prazo.
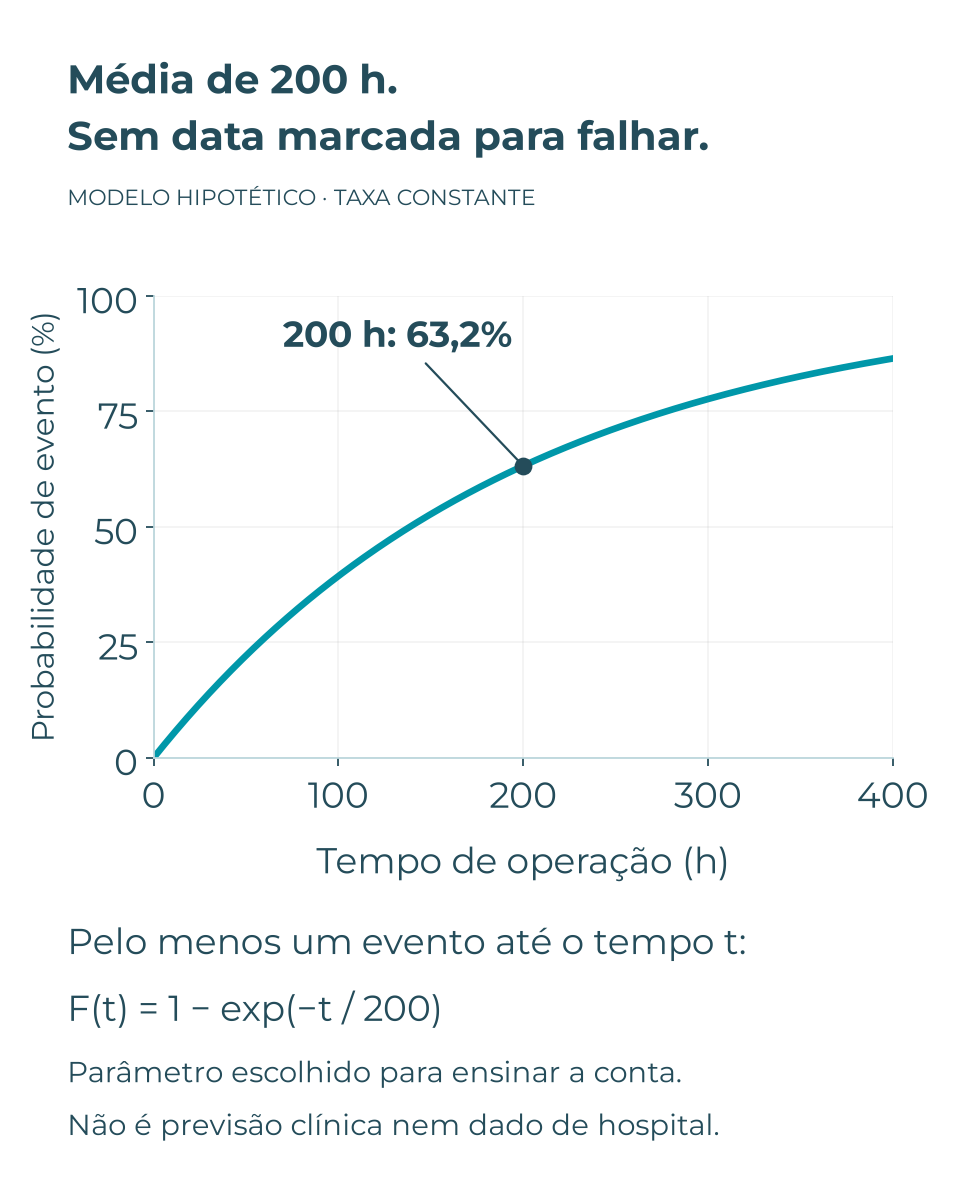
Depois, a média admite dispersão. Um evento pode acontecer muito antes ou muito depois dela. Para mostrar a diferença, considere um modelo inteiramente hipotético, com taxa constante e tempo médio entre eventos de 200 horas. Nesse modelo, a probabilidade de pelo menos um evento até o tempo t é 1 − exp(−t/200). A relação exponencial e o processo de eventos recorrentes são descritos pelo NIST. [2] [3]
| Tempo de operação no modelo fictício | Probabilidade calculada de pelo menos um evento |
|---|---|
| 0 h | 0,0% |
| 50 h | 22,1% |
| 100 h | 39,3% |
| 200 h | 63,2% |
| 400 h | 86,5% |
Aos 200 h, o modelo ainda atribui 36,8% à ausência de evento. Esses resultados usam um parâmetro escolhido para ensinar a conta, sem ajuste a dados hospitalares. A curva não estima o risco clínico de um aparelho nem demonstra que a frota real siga uma taxa constante.
Dois painéis com o mesmo MTBF têm a mesma precisão?
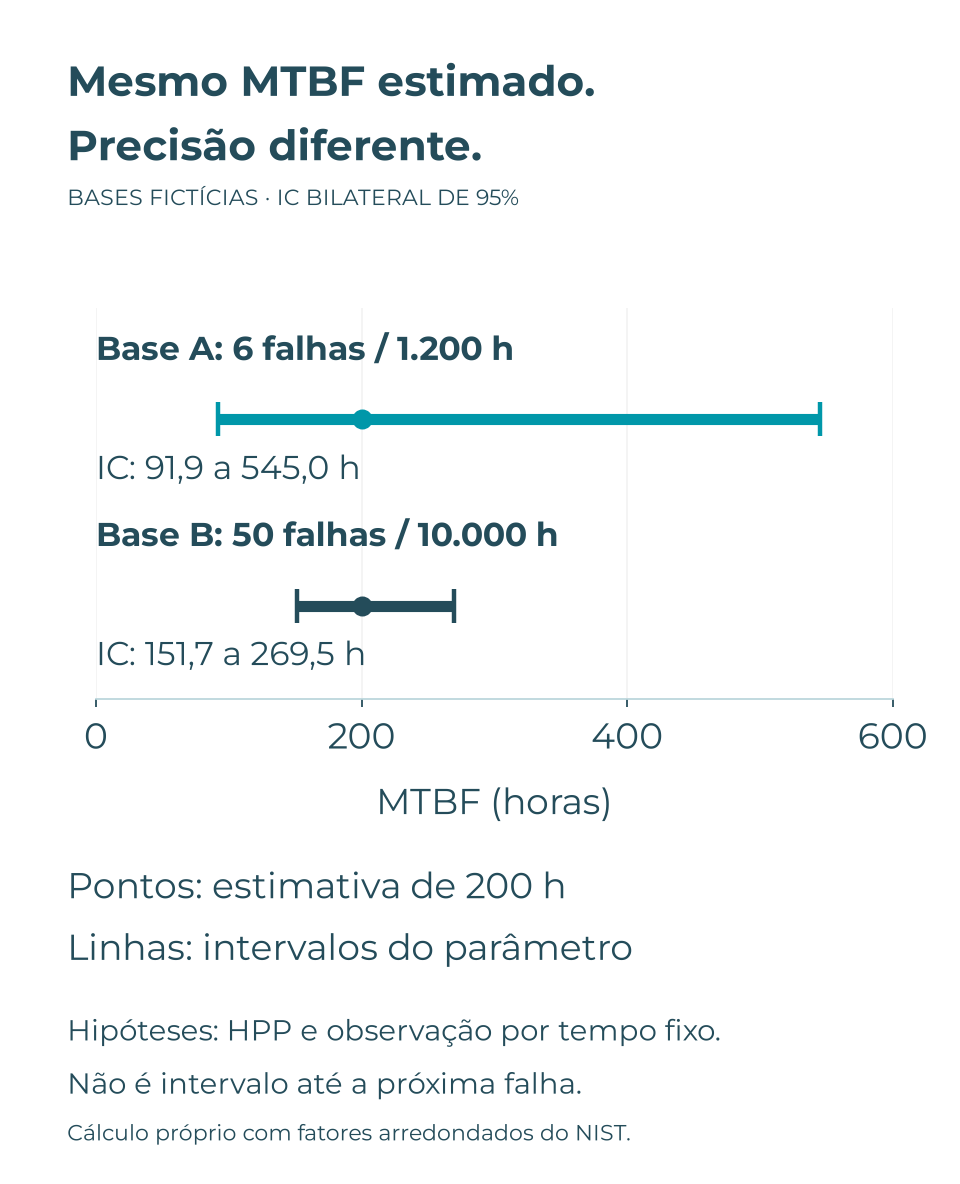
Uma estimativa pontual deve vir acompanhada de sua base. O NIST fornece fatores de intervalo de confiança para o modelo HPP, com observação de sistemas reparáveis por tempo fixo. Aplicados a dois conjuntos fictícios, ambos com estimativa de 200 h, dão: [4]
| Conjunto fictício | Exposição operacional | Falhas | Estimativa de MTBF | IC bilateral de 95%, arredondado |
|---|---|---|---|---|
| A | 1.200 h | 6 | 200 h | 91,9 a 545,0 h |
| B | 10.000 h | 50 | 200 h | 151,7 a 269,5 h |
Foram usados os fatores publicados de 0,4594/2,7249 e 0,7585/1,3473, multiplicados por 200 h. A base B produz intervalo mais estreito sob as mesmas hipóteses. A confiança descreve a cobertura do método em repetições, não a probabilidade de falha individual nem o intervalo previsto até a próxima ocorrência. Mudanças de taxa, seleção e registros incompletos exigem outra análise. [4]
Se não houve falhas, informe “zero eventos em tantas horas observadas”, com população e período. A razão com denominador zero não fornece uma estimativa finita; essa janela sem eventos não demonstra vida infinita.
Um MTBF maior prova que a manutenção melhorou?
Uma mudança do indicador pode ser compatível com melhoria, mas também com alteração de uso ou registro. Antes de atribuir o resultado à preventiva, confira se houve troca de ativos, redução de carga, mudança do critério de falha ou perda de cobertura das OS.
| O que mudou? | Informação para conferir | Decisão que essa conferência ajuda |
|---|---|---|
| Horas de uso e regime operacional | Exposição, carga e ambiente por ativo | Comparar grupos e condições semelhantes |
| Registro das ocorrências | Critérios, auditoria de OS e vínculos de retorno | Separar mudança de medição de mudança do processo |
| Composição da frota | Entradas, saídas e modelos observados | Evitar atribuir à manutenção o efeito da troca de equipamentos |
| Consequência das falhas | Função perdida, criticidade e tempo de indisponibilidade | Investigar eventos relevantes mesmo quando a média parece boa |
Não avalie apenas o número agregado. Uma família com eventos raros pode conter um modo de falha com consequência importante. Frequência, função, consequência e resposta da instituição precisam ser considerados na investigação.
Um estudo brasileiro de Silva e colegas, publicado em 2025, analisou registros de bombas de infusão de 2008 a 2021. Os autores ajustaram distribuições para tempos entre falhas e de reparo e escolheram modelos Weibull nas análises apresentadas. Também apontaram descrições genéricas de ocorrência e problemas de fechamento de OS. Uma média não substitui a análise dos registros e do modelo. O caso é de um hospital e não valida a hipótese de taxa constante para outra frota. [5]
Como sair da média e investigar uma falha recorrente?
Comece por uma pergunta verificável: qual função deixou de ser cumprida, em que condição e com que evidência? “Não funciona” é um ponto de partida pouco específico. Acrescente observação, identificação do ativo, contexto, intervenção e resultado da verificação, preservando o que foi observado e o que ainda é hipótese.
A análise por árvore de falhas, ou Fault Tree Analysis (FTA), parte de um evento indesejado definido e representa combinações de eventos que podem produzi-lo. O manual da NASA explica que a árvore é delimitada pelo evento de topo e não enumera automaticamente todas as falhas possíveis do sistema. Uma árvore qualitativa também não fornece probabilidades sem dados e hipóteses adicionais. [6]
| Relação lógica | Significado básico | Pergunta para revisar o modelo |
|---|---|---|
| OU | Uma ou mais entradas podem produzir a saída | Cada entrada é suficiente no cenário definido? |
| E | Todas as entradas são necessárias para produzir a saída | As condições são simultâneas? Há dependências entre elas? |
A IEC 61025:2006, edição 2.0 no catálogo oficial, trata de FTA, pressupostos, eventos, modos de falha e símbolos. O catálogo foi consultado para edição e escopo; as explicações lógicas acima se apoiam no manual público da NASA. Uma lista de causas possíveis, sem relações lógicas ou evidência, ainda precisa ser desenvolvida para sustentar uma análise. [6] [7]
Depois de formular a hipótese, defina responsável, evidência a coletar e critério para avaliar a intervenção. Registre o que foi feito e compare períodos com a mesma regra de medição. O aumento do MTBF, isoladamente, não demonstra que uma causa específica foi eliminada.
Que registros ajudam a transformar MTBF em uma decisão?
Guarde a identidade do ativo, sua exposição, o modo de falha, os marcos da OS e o resultado das intervenções. Reconstrua o indicador a partir desses registros antes de usar uma mudança da série para justificar investimento ou revisão de manutenção.
O CMMS da Arkmeds oferece histórico por ativo, fluxo de OS e painéis personalizáveis com MTBF, MTTR e SLA, conforme a documentação oficial. Essa estrutura ajuda a relacionar o painel ao registro da ocorrência e ao acompanhamento das ações. As funcionalidades precisam de definições e dados coerentes para que o número possa ser interpretado. [8]
Ao apresentar MTBF à equipe, leve uma ficha com população, período, horas observadas, falhas, regras e incerteza. A pergunta útil deixa de ser “em que dia o aparelho vai falhar?” e passa a ser “o que esta base permite concluir e qual evidência falta para agir?”.
Fontes e leituras
- NIST/SEMATECH. e-Handbook §8.4.1.2 — Maximum likelihood estimation.
- NIST/SEMATECH. e-Handbook §8.1.7.1 — Homogeneous Poisson Process.
- NIST/SEMATECH. e-Handbook §8.1.6.1 — Exponential.
- NIST/SEMATECH. e-Handbook §8.4.5.1 — Constant repair rate (HPP/exponential) model.
- Silva et al. (2025). Reliability analysis of hospital infusion pumps: a case study. BioMedical Engineering OnLine 24,55.
- NASA (2002). Fault Tree Handbook with Aerospace Applications, version 1.1.
- IEC 61025:2006 — Fault tree analysis (FTA), edition2.0.
- Arkmeds. Plataforma de gestão da manutenção — funcionalidades oficiais.
Exemplos e cálculos elaborados para ensinar a interpretação; não representam dados de clientes. Resultados publicados recebem referência própria. A Arkmeds fornece o CMMS mencionado. Pesquisa e revisão: 6 de outubro de 2026.